
Advanced Configuration

This notebook demonstrates advanced configuration options and customisation capabilities of the history matching library.

Overview

Building on the basic and manual workflows, we’ll explore: - Single-constructor configuration and DataFrame-based inputs - Custom sampling strategies and emulator types - Feature selection strategies and switching between iterations - Progress callbacks and monitoring - Performance comparison across configurations - Checkpoint and resume functionality

We reuse the stochastic SIR model from model.py. For the basic automated workflow see Basic Workflow; for the manual step-by-step workflow see Manual Workflow.

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from pathlib import Path

import historymatching as hm
import logging; logging.getLogger("historymatching").propagate = False  # keep INFO logs out of the rendered docs
from model import SIR, generate_observed_data

%matplotlib inline
np.random.seed(42)
WARNING: All log messages before absl::InitializeLog() is called are written to STDERR
I0000 00:00:1794256773.457746    3513 cudart_stub.cc:31] Could not find cuda drivers on your machine, GPU will not be used.
I0000 00:00:1794256773.498580    3513 cpu_feature_guard.cc:227] This TensorFlow binary is optimized to use available CPU instructions in performance-critical operations.
To enable the following instructions: AVX2 FMA, in other operations, rebuild TensorFlow with the appropriate compiler flags.
WARNING: All log messages before absl::InitializeLog() is called are written to STDERR
I0000 00:00:1794256774.647837    3513 cudart_stub.cc:31] Could not find cuda drivers on your machine, GPU will not be used.
/home/runner/work/historymatching/historymatching/.venv/lib/python3.13/site-packages/gpflow/versions.py:1: UserWarning: pkg_resources is deprecated as an API. See https://setuptools.pypa.io/en/latest/pkg_resources.html. The pkg_resources package is slated for removal as early as 2025-11-30. Refrain from using this package or pin to Setuptools<81.
  import pkg_resources

Generate Synthetic Observed Data

beta_true = 1.3
gamma_true = 0.5
population_size = 10_000
initial_infected = 100

incidence_obs, true_model = generate_observed_data(
    beta_true=beta_true,
    gamma_true=gamma_true,
    population_size=population_size,
    n_seed_infections=initial_infected,
)
incidence_obs = incidence_obs.values  # numpy array for convenience below

print(f"True parameters: β={beta_true}, γ={gamma_true}, R₀={beta_true/gamma_true:.2f}")
print(f"Peak incidence: {incidence_obs.max():.0f}, Total cases: {incidence_obs.sum():.0f}")
True parameters: β=1.3, γ=0.5, R₀=2.60
Peak incidence: 1576, Total cases: 9091
def enhanced_sir_simulation(samples: pd.DataFrame) -> pd.DataFrame:
    """
    Enhanced simulation function that returns more features.
    """
    results = []
    
    for _, row in samples.iterrows():
        model = SIR(
            beta=row['beta'],
            gamma=row['gamma'],
            s0=population_size - initial_infected,
            i0=initial_infected
        )
        
        S, I, R = model.run()
        incidence = model.get_incidence()
        
        # Create comprehensive feature set
        result = {}
        
        # Time series features (every other day to reduce dimensionality)
        for i in range(0, len(incidence), 2):
            result[f'incidence_day_{i}'] = incidence[i]
            result[f'infected_day_{i}'] = I[i]
        
        # Summary statistics
        result['peak_incidence'] = max(incidence)
        result['peak_incidence_day'] = np.argmax(incidence)
        result['total_cases'] = sum(incidence)
        result['attack_rate'] = sum(incidence) / population_size
        result['final_size'] = R[-1]
        result['max_infected'] = max(I)
        
        # Epidemic characteristics
        result['time_to_peak'] = np.argmax(incidence)
        result['epidemic_duration'] = len([x for x in incidence[1:] if x > 0])
        result['growth_rate'] = np.log(incidence[3] / incidence[1]) if incidence[1] > 0 and incidence[3] > 0 else 0
        
        # Cumulative features
        cumulative_cases = np.cumsum(incidence)
        result['cases_week_1'] = cumulative_cases[6] if len(cumulative_cases) > 6 else cumulative_cases[-1]
        result['cases_week_2'] = cumulative_cases[13] if len(cumulative_cases) > 13 else cumulative_cases[-1]
        
        results.append(result)
    
    return pd.DataFrame(results)

# Test the enhanced simulation
test_samples = pd.DataFrame({
    'beta': [1.0, 1.5],
    'gamma': [0.3, 0.5]
})

test_results = enhanced_sir_simulation(test_samples)
print(f"Enhanced simulation produces {len(test_results.columns)} features:")
print(f"Features: {list(test_results.columns[:10])}...")
Enhanced simulation produces 31 features:
Features: ['incidence_day_0', 'infected_day_0', 'incidence_day_2', 'infected_day_2', 'incidence_day_4', 'infected_day_4', 'incidence_day_6', 'infected_day_6', 'incidence_day_8', 'infected_day_8']...

Advanced configuration

The single hm.HistoryMatching(...) constructor provides fine-grained control over all aspects of the history matching workflow.

# Create parameter space using DataFrame for more control
parameter_df = pd.DataFrame({
    'parameter': ['beta', 'gamma'],
    'minimum': [0.5, 0.1],
    'maximum': [3.0, 1.0],
    'description': ['Transmission rate per day', 'Recovery rate per day']
})

# Create comprehensive observations - mix of summary stats and time series
observations_df = pd.DataFrame({
    'feature': [
        'peak_incidence',
        'total_cases', 
        'attack_rate',
        'time_to_peak',
        'incidence_day_4',
        'incidence_day_8',
        'incidence_day_12',
        'cases_week_1',
        'cases_week_2'
    ],
    'mean': [
        max(incidence_obs),
        sum(incidence_obs),
        sum(incidence_obs) / population_size,
        np.argmax(incidence_obs),
        incidence_obs[4],
        incidence_obs[8], 
        incidence_obs[12],
        sum(incidence_obs[:7]),
        sum(incidence_obs[:14])
    ],
    'std': [
        50,    # Peak incidence uncertainty
        200,   # Total cases uncertainty
        0.02,  # Attack rate uncertainty
        1,     # Time to peak uncertainty (days)
        30,    # Daily incidence uncertainty
        40,
        25,
        100,   # Weekly totals uncertainty
        150
    ]
})

print(f"Advanced parameter space ({len(parameter_df)} parameters):")
print(parameter_df)
print(f"\nComprehensive observations ({len(observations_df)} features):")
print(observations_df)
Advanced parameter space (2 parameters):
  parameter  minimum  maximum                description
0      beta      0.5      3.0  Transmission rate per day
1     gamma      0.1      1.0      Recovery rate per day

Comprehensive observations (9 features):
            feature       mean     std
0    peak_incidence  1576.0000   50.00
1       total_cases  9091.0000  200.00
2       attack_rate     0.9091    0.02
3      time_to_peak     5.0000    1.00
4   incidence_day_4  1246.0000   30.00
5   incidence_day_8   810.0000   40.00
6  incidence_day_12   130.0000   25.00
7      cases_week_1  5696.0000  100.00
8      cases_week_2  8939.0000  150.00
# Create advanced history matching with full configuration control
print("Building advanced history matching engine...")

advanced_engine = hm.HistoryMatching(
    bounds=parameter_df,
    observations=observations_df,
    function=enhanced_sir_simulation,
    sampling_strategy={
        'type': 'lhs',
        'criterion': 'maximin',  # Maximize minimum distance between points
        'iterations': 10         # LHS optimization iterations
    },
    feature_selection={
        'method': 'mean_sq_z',       # mean-squared z-score selection
        'max_features': 3,           # Limit features per iteration
        'correlation_threshold': 0.8 # Avoid highly correlated features
    },
    emulator_type='bayes_linear',
    n_samples=800,
    max_iterations=6,
    implausibility_threshold=2.8,
    auto_reduce_space=False,
    oversample_factor=5.0,
    random_seed=789,
)

# Summarize the configuration
print("Configuration summary:")
print(f"  parameters: {advanced_engine.parameters}")
print(f"  observations: {advanced_engine.outputs}")
print(f"  emulator type: bayes_linear")
print(f"  n_samples: 800")
print(f"  max_iterations: 6")
print(f"  implausibility_threshold: 2.8")
print(f"  oversample_factor: 5.0")
Building advanced history matching engine...
Configuration summary:
  parameters: ['beta', 'gamma']
  observations: ['peak_incidence', 'total_cases', 'attack_rate', 'time_to_peak', 'incidence_day_4', 'incidence_day_8', 'incidence_day_12', 'cases_week_1', 'cases_week_2']
  emulator type: bayes_linear
  n_samples: 800
  max_iterations: 6
  implausibility_threshold: 2.8
  oversample_factor: 5.0
# The engine was configured and built in the previous cell
print(f" Advanced engine built successfully!")
print(f" Parameters: {len(advanced_engine.parameter_space.get_parameter_names())}")
print(f" Observations: {len(observations_df)}")
print(f" Sampling strategy: {advanced_engine.sampling_strategy.get_strategy_name()}")
print(f" Feature selection: {advanced_engine.feature_selection.get_strategy_name()}")
print(f" Emulator type: {type(advanced_engine.emulator_factory).__name__}")
print(f" Implausibility threshold: {advanced_engine.implausibility_threshold}")
print(f" Oversample factor: {advanced_engine.oversample_factor}")
 Advanced engine built successfully!
 Parameters: 2
 Observations: 9
 Sampling strategy: Latin Hypercube Sampling (criterion=maximin)
 Feature selection: Auto Selection (method=mean_sq_z, max=3)
 Emulator type: EmulatorFactory
 Implausibility threshold: 2.8
 Oversample factor: 5.0

Interactive Workflow with Advanced Controls

Let’s use the interactive workflow to demonstrate advanced features like strategy switching and diagnostics.

# Add progress callback to monitor the workflow
def progress_callback(progress):
    print(f"  Progress update: Iteration {progress.current_iteration}, "
          f"Acceptance rate: {progress.acceptance_rate:.3f}, "
          f"Total emulators: {progress.emulators_trained}")

advanced_engine.add_progress_callback(progress_callback)

print("Starting interactive advanced workflow...")
print(f"Initial parameter ranges:")
for param_name in advanced_engine.parameter_space.get_parameter_names():
    bounds = advanced_engine.parameter_space.get_bounds(param_name)
    print(f"  {param_name}: [{bounds[0]}, {bounds[1]}]")
Starting interactive advanced workflow...
Initial parameter ranges:
  beta: [0.5, 3.0]
  gamma: [0.1, 1.0]
# Iteration 1: Automatic feature selection
print("\n Iteration 1: Using automatic feature selection...")
result1 = advanced_engine.step()

print(f" Iteration 1 results:")
print(f" Samples generated: {len(result1.samples)}")
print(f" Features selected: {result1.emulated_outputs}")
print(f" Parameter ranges after filtering:")
for param in ['beta', 'gamma']:
    values = result1.samples[param]
    print(f"    {param}: [{values.min():.3f}, {values.max():.3f}]")
    
# Check emulator quality (in real workflow, you'd inspect diagnostics)
print(f" Emulators trained: {len(result1.emulators)}")

# Accept iteration 1
print(" Accepting iteration 1...")
advanced_engine.commit_step()

 Iteration 1: Using automatic feature selection...
 Iteration 1 results:
 Samples generated: 800
 Features selected: ['cases_week_1', 'incidence_day_4', 'incidence_day_8']
 Parameter ranges after filtering:
    beta: [0.501, 2.999]
    gamma: [0.101, 0.999]
 Emulators trained: 3
 Accepting iteration 1...
  Progress update: Iteration 1, Acceptance rate: 0.010, Total emulators: 3
# Iteration 2: Switch to manual feature selection
print("\n Iteration 2: Switching to manual feature selection...")

# Update strategy to focus on key summary statistics
advanced_engine.feature_selection = ['peak_incidence', 'attack_rate']
print(f" Updated to manual feature selection: ['peak_incidence', 'attack_rate']")

result2 = advanced_engine.step()

print(f" Iteration 2 results:")
print(f" Samples generated: {len(result2.samples)}")
print(f" Acceptance rate: {advanced_engine.acceptance_rate:.3f}")
print(f" Features selected: {result2.emulated_outputs}")
print(f" Parameter ranges:")
for param in ['beta', 'gamma']:
    values = result2.samples[param]
    print(f"    {param}: [{values.min():.3f}, {values.max():.3f}]")

print(" Accepting iteration 2...")
advanced_engine.commit_step()

 Iteration 2: Switching to manual feature selection...
 Updated to manual feature selection: ['peak_incidence', 'attack_rate']
 Iteration 2 results:
 Samples generated: 800
 Acceptance rate: 0.015
 Features selected: ['peak_incidence', 'attack_rate']
 Parameter ranges:
    beta: [1.016, 1.569]
    gamma: [0.131, 0.793]
 Accepting iteration 2...
  Progress update: Iteration 2, Acceptance rate: 0.015, Total emulators: 5
# Iteration 3: Switch emulator type and continue
print("\n Iteration 3: Switching to linear emulator for comparison...")

# Switch to a simpler emulator to see the difference
advanced_engine.emulator_type = 'linear'
print(f" Updated emulator type to: linear")

# Use time series features this time
advanced_engine.feature_selection = ['incidence_day_4', 'incidence_day_8']
print(f" Updated to time series features: ['incidence_day_4', 'incidence_day_8']")

result3 = advanced_engine.step()

print(f" Iteration 3 results:")
print(f" Samples generated: {len(result3.samples)}")
print(f" Acceptance rate: {advanced_engine.acceptance_rate:.3f}")
print(f" Features selected: {result3.emulated_outputs}")

# Check if linear emulator performed poorly
if advanced_engine.acceptance_rate < 0.1:
    print(f"   Low acceptance rate with linear emulator - reverting to bayes_linear")
    advanced_engine.revert_step()  # Revert this iteration
    
    # Switch back to bayes_linear and retry
    advanced_engine.emulator_type = 'bayes_linear'
    result3 = advanced_engine.step()
    print(f"   Retried with bayes_linear: {len(result3.samples)} samples, rate: {advanced_engine.acceptance_rate:.3f}")

print(" Accepting iteration 3...")
advanced_engine.commit_step()

print(f"\n Interactive workflow completed!")
print(f" Total iterations: {advanced_engine.current_iteration}")
print(f" Final acceptance rate: {advanced_engine.acceptance_rate:.3f}")

 Iteration 3: Switching to linear emulator for comparison...
 Updated emulator type to: linear
 Updated to time series features: ['incidence_day_4', 'incidence_day_8']
 Iteration 3 results:
 Samples generated: 800
 Acceptance rate: 0.019
 Features selected: ['incidence_day_4', 'incidence_day_8']
   Low acceptance rate with linear emulator - reverting to bayes_linear
   Retried with bayes_linear: 800 samples, rate: 0.015
 Accepting iteration 3...
  Progress update: Iteration 3, Acceptance rate: 0.015, Total emulators: 7

 Interactive workflow completed!
 Total iterations: 3
 Final acceptance rate: 0.015

Advanced Analysis and Diagnostics

# Get all results for analysis
all_results = advanced_engine.get_all_results()
final_samples = advanced_engine.get_nroy_samples()

print(f" Advanced Analysis Results:")
print(f" Total iterations completed: {len(all_results)}")
print(f" Final plausible samples: {len(final_samples)}")
print(f" Total emulators trained: {advanced_engine.emulators_trained}")
print(f" Total samples evaluated: {advanced_engine.samples_generated}")

# Parameter estimation summary
print(f"\n Parameter Recovery Assessment:")
for param, true_value in [('beta', beta_true), ('gamma', gamma_true)]:
    values = final_samples[param]
    median_est = values.median()
    ci_lower = values.quantile(0.025)
    ci_upper = values.quantile(0.975)
    
    in_ci = ci_lower <= true_value <= ci_upper
    relative_error = abs(median_est - true_value) / true_value
    
    print(f"  {param}: Estimated {median_est:.3f} (95% CI: [{ci_lower:.3f}, {ci_upper:.3f}])")
    print(f"       True value: {true_value} {'' if in_ci else '❌'} ({'in' if in_ci else 'out of'} CI)")
    print(f"       Relative error: {relative_error:.1%}")

# Check R0 recovery
R0_samples = final_samples['beta'] / final_samples['gamma']
R0_true = beta_true / gamma_true
R0_median = R0_samples.median()
R0_ci_lower = R0_samples.quantile(0.025)
R0_ci_upper = R0_samples.quantile(0.975)
R0_in_ci = R0_ci_lower <= R0_true <= R0_ci_upper

print(f"\n Derived Parameter (R₀):")
print(f" Estimated: {R0_median:.3f} (95% CI: [{R0_ci_lower:.3f}, {R0_ci_upper:.3f}])")
print(f" True value: {R0_true:.3f} {'' if R0_in_ci else '❌'}")
 Advanced Analysis Results:
 Total iterations completed: 3
 Final plausible samples: 800
 Total emulators trained: 7
 Total samples evaluated: 216150

 Parameter Recovery Assessment:
  beta: Estimated 1.334 (95% CI: [1.187, 1.484])
       True value: 1.3  (in CI)
       Relative error: 2.6%
  gamma: Estimated 0.513 (95% CI: [0.352, 0.644])
       True value: 0.5  (in CI)
       Relative error: 2.7%

 Derived Parameter (R₀):
 Estimated: 2.620 (95% CI: [2.283, 3.397])
 True value: 2.600 
# Advanced visualization
fig, axes = plt.subplots(2, 3, figsize=(18, 12))

# Plot 1: Parameter evolution across iterations
ax = axes[0, 0]
colors = ['lightblue', 'orange', 'lightgreen', 'red']
for i, result in enumerate(all_results):
    if i < len(colors):
        ax.scatter(result.samples['beta'], result.samples['gamma'], 
                  alpha=0.6, s=20, color=colors[i], label=f'Iteration {i+1}')

ax.axvline(beta_true, color='red', linestyle='--', linewidth=2, alpha=0.8)
ax.axhline(gamma_true, color='red', linestyle='--', linewidth=2, alpha=0.8)
ax.set_xlabel('β (transmission rate)')
ax.set_ylabel('γ (recovery rate)')
ax.set_title('Parameter Space Evolution')
ax.legend()
ax.grid(True, alpha=0.3)

# Plot 2: Final parameter distributions
ax = axes[0, 1]
ax.hist(final_samples['beta'], bins=25, alpha=0.7, color='blue', density=True, label='β')
ax.axvline(beta_true, color='red', linestyle='--', linewidth=2, label=f'True β = {beta_true}')
ax.axvline(final_samples['beta'].median(), color='blue', linestyle='-', linewidth=2, 
           label=f'Est. β = {final_samples["beta"].median():.2f}')
ax.set_xlabel('β')
ax.set_ylabel('Density')
ax.set_title('β Distribution')
ax.legend()
ax.grid(True, alpha=0.3)

ax = axes[0, 2]
ax.hist(final_samples['gamma'], bins=25, alpha=0.7, color='orange', density=True, label='γ')
ax.axvline(gamma_true, color='red', linestyle='--', linewidth=2, label=f'True γ = {gamma_true}')
ax.axvline(final_samples['gamma'].median(), color='orange', linestyle='-', linewidth=2,
           label=f'Est. γ = {final_samples["gamma"].median():.2f}')
ax.set_xlabel('γ')
ax.set_ylabel('Density')
ax.set_title('γ Distribution')
ax.legend()
ax.grid(True, alpha=0.3)

# Plot 3: R0 distribution
ax = axes[1, 0]
ax.hist(R0_samples, bins=25, alpha=0.7, color='purple', density=True)
ax.axvline(R0_true, color='red', linestyle='--', linewidth=2, label=f'True R₀ = {R0_true:.2f}')
ax.axvline(R0_median, color='purple', linestyle='-', linewidth=2, label=f'Est. R₀ = {R0_median:.2f}')
ax.set_xlabel('R₀')
ax.set_ylabel('Density')
ax.set_title('R₀ Distribution')
ax.legend()
ax.grid(True, alpha=0.3)

# Plot 4: Acceptance rate evolution
ax = axes[1, 1]
iterations = range(1, len(all_results) + 1)
sample_counts = [len(result.samples) for result in all_results]
ax.bar(iterations, sample_counts, alpha=0.7, color='green')
ax.set_xlabel('Iteration')
ax.set_ylabel('Plausible Samples')
ax.set_title('Sample Count per Iteration')
ax.grid(True, alpha=0.3)

# Plot 5: Feature selection summary
ax = axes[1, 2]
all_features = []
for result in all_results:
    all_features.extend(result.emulated_outputs)

feature_counts = pd.Series(all_features).value_counts()
feature_counts.plot(kind='bar', ax=ax, color='teal', alpha=0.7)
ax.set_xlabel('Features')
ax.set_ylabel('Times Selected')
ax.set_title('Feature Selection Frequency')
ax.tick_params(axis='x', rotation=45)
ax.grid(True, alpha=0.3)

plt.tight_layout()
plt.show()

print(f"\n Feature Selection Summary:")
for feature, count in feature_counts.head().items():
    print(f"  {feature}: used {count} time(s)")
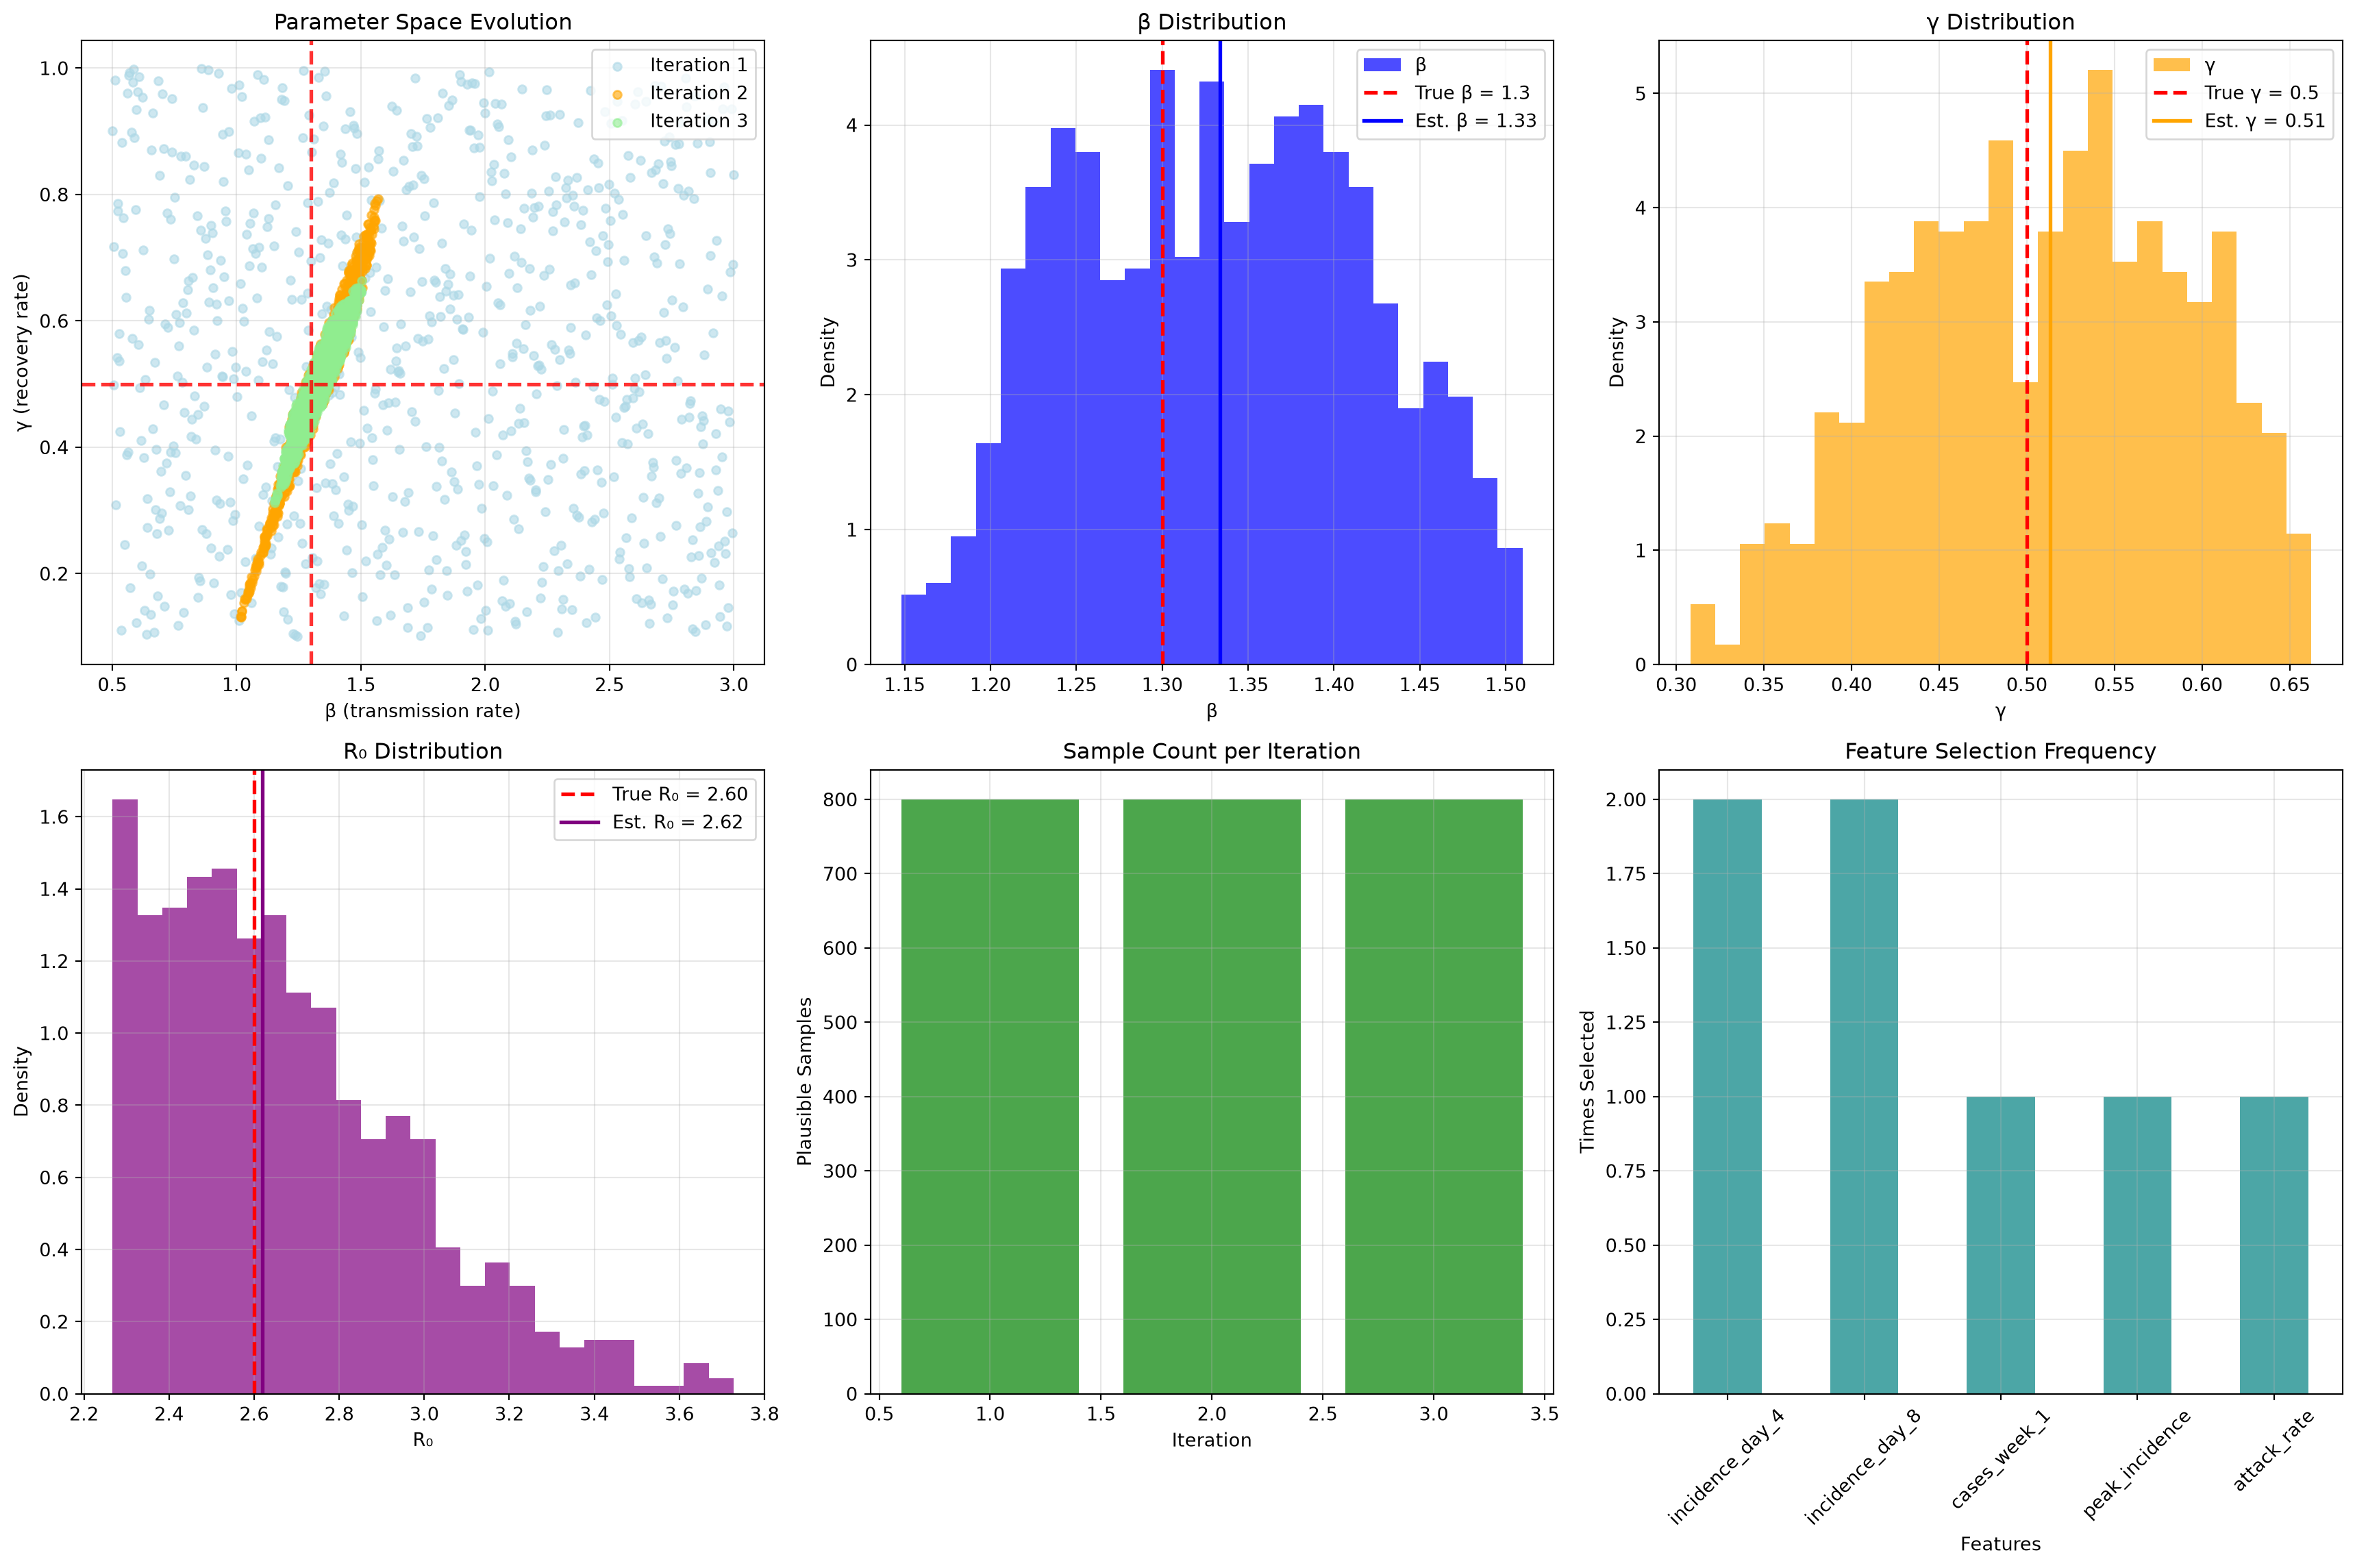
 Feature Selection Summary:
  incidence_day_4: used 2 time(s)
  incidence_day_8: used 2 time(s)
  cases_week_1: used 1 time(s)
  peak_incidence: used 1 time(s)
  attack_rate: used 1 time(s)

Performance Comparison: Different Configurations

Let’s compare different configuration strategies to understand their impact.

def run_quick_comparison(config_name, sampling_strategy='lhs', emulator_type='bayes_linear',
                         implausibility_threshold=3.0):
    """Run a quick 2-iteration comparison with different settings."""
    import time
    print(f"\nTesting {config_name}...")

    simple_obs = {
        'peak_incidence': (max(incidence_obs), 50),
        'total_cases':    (sum(incidence_obs), 200),
    }

    engine = hm.HistoryMatching(
        bounds={'beta': (0.5, 3.0), 'gamma': (0.1, 1.0)},
        observations=simple_obs,
        function=enhanced_sir_simulation,
        sampling_strategy=sampling_strategy,
        emulator_type=emulator_type,
        n_samples=200,
        max_iterations=2,
        implausibility_threshold=implausibility_threshold,
        random_seed=999,
    )

    start_time = time.time()
    results = engine.run()
    end_time = time.time()

    final_samples = engine.get_nroy_samples()
    beta_error  = abs(final_samples['beta'].median()  - beta_true)  / beta_true
    gamma_error = abs(final_samples['gamma'].median() - gamma_true) / gamma_true

    print(f"  Runtime: {end_time - start_time:.1f}s")
    print(f"  Final samples: {len(final_samples)}")
    print(f"  beta error: {beta_error:.1%}, gamma error: {gamma_error:.1%}")
    print(f"  Final acceptance rate: {engine.acceptance_rate:.3f}")

    return {
        'config':          config_name,
        'runtime':         end_time - start_time,
        'samples':         len(final_samples),
        'beta_error':      beta_error,
        'gamma_error':     gamma_error,
        'acceptance_rate': engine.acceptance_rate,
    }

# Compare configurations
comparisons = []
comparisons.append(run_quick_comparison("LHS + BL (baseline)",    sampling_strategy='lhs',    emulator_type='bayes_linear'))
comparisons.append(run_quick_comparison("LHS + Linear",             sampling_strategy='lhs',    emulator_type='linear'))
comparisons.append(run_quick_comparison("Random + BL",             sampling_strategy='random', emulator_type='bayes_linear'))
comparisons.append(run_quick_comparison("LHS + BL (conservative)", sampling_strategy='lhs',    emulator_type='bayes_linear',
                                         implausibility_threshold=2.5))

Testing LHS + BL (baseline)...
  Runtime: 5.9s
  Final samples: 200
  beta error: 6.3%, gamma error: 8.5%
  Final acceptance rate: 0.113

Testing LHS + Linear...
  Runtime: 5.2s
  Final samples: 200
  beta error: 3.6%, gamma error: 22.4%
  Final acceptance rate: 0.300

Testing Random + BL...
  Runtime: 6.0s
  Final samples: 200
  beta error: 6.6%, gamma error: 13.1%
  Final acceptance rate: 0.110

Testing LHS + BL (conservative)...
  Runtime: 5.5s
  Final samples: 200
  beta error: 3.8%, gamma error: 10.9%
  Final acceptance rate: 0.067
# Summarize comparison results
comparison_df = pd.DataFrame(comparisons)

print("\n Configuration Comparison Summary:")
print("=" * 80)
print(f"{'Configuration':<25} {'Runtime(s)':<12} {'Samples':<10} {'β Error':<10} {'γ Error':<10} {'Acc. Rate':<10}")
print("=" * 80)

for _, row in comparison_df.iterrows():
    print(f"{row['config']:<25} {row['runtime']:<12.1f} {row['samples']:<10} "
          f"{row['beta_error']:<10.1%} {row['gamma_error']:<10.1%} {row['acceptance_rate']:<10.3f}")

print("\n Best performing configurations:")
print(f" Fastest: {comparison_df.loc[comparison_df['runtime'].idxmin(), 'config']}")
print(f" Most samples: {comparison_df.loc[comparison_df['samples'].idxmax(), 'config']}")
print(f" Lowest β error: {comparison_df.loc[comparison_df['beta_error'].idxmin(), 'config']}")
print(f" Lowest γ error: {comparison_df.loc[comparison_df['gamma_error'].idxmin(), 'config']}")

# Plot comparison — one panel per varying metric: runtime, accuracy, acceptance rate
fig, axes = plt.subplots(1, 3, figsize=(15, 5))

# Runtime comparison
ax = axes[0]
comparison_df.plot(x='config', y='runtime', kind='bar', ax=ax, color='skyblue')
ax.set_title('Runtime Comparison')
ax.set_ylabel('Time (seconds)')
ax.tick_params(axis='x', rotation=45)

# Error comparison
ax = axes[1]
x = range(len(comparison_df))
width = 0.35
ax.bar([i - width/2 for i in x], comparison_df['beta_error'], width, label='β error', alpha=0.7)
ax.bar([i + width/2 for i in x], comparison_df['gamma_error'], width, label='γ error', alpha=0.7)
ax.set_xlabel('Configuration')
ax.set_ylabel('Relative Error')
ax.set_title('Parameter Estimation Error')
ax.set_xticks(x)
ax.set_xticklabels([c[:15] + '...' if len(c) > 15 else c for c in comparison_df['config']], rotation=45)
ax.legend()

# Acceptance rate comparison (final sample count is fixed at n_samples, so plot the
# metric that actually varies across configurations)
ax = axes[2]
comparison_df.plot(x='config', y='acceptance_rate', kind='bar', ax=ax, color='salmon', legend=False)
ax.set_title('Final Acceptance Rate')
ax.set_ylabel('Acceptance rate')
ax.tick_params(axis='x', rotation=45)

plt.tight_layout()
plt.show()

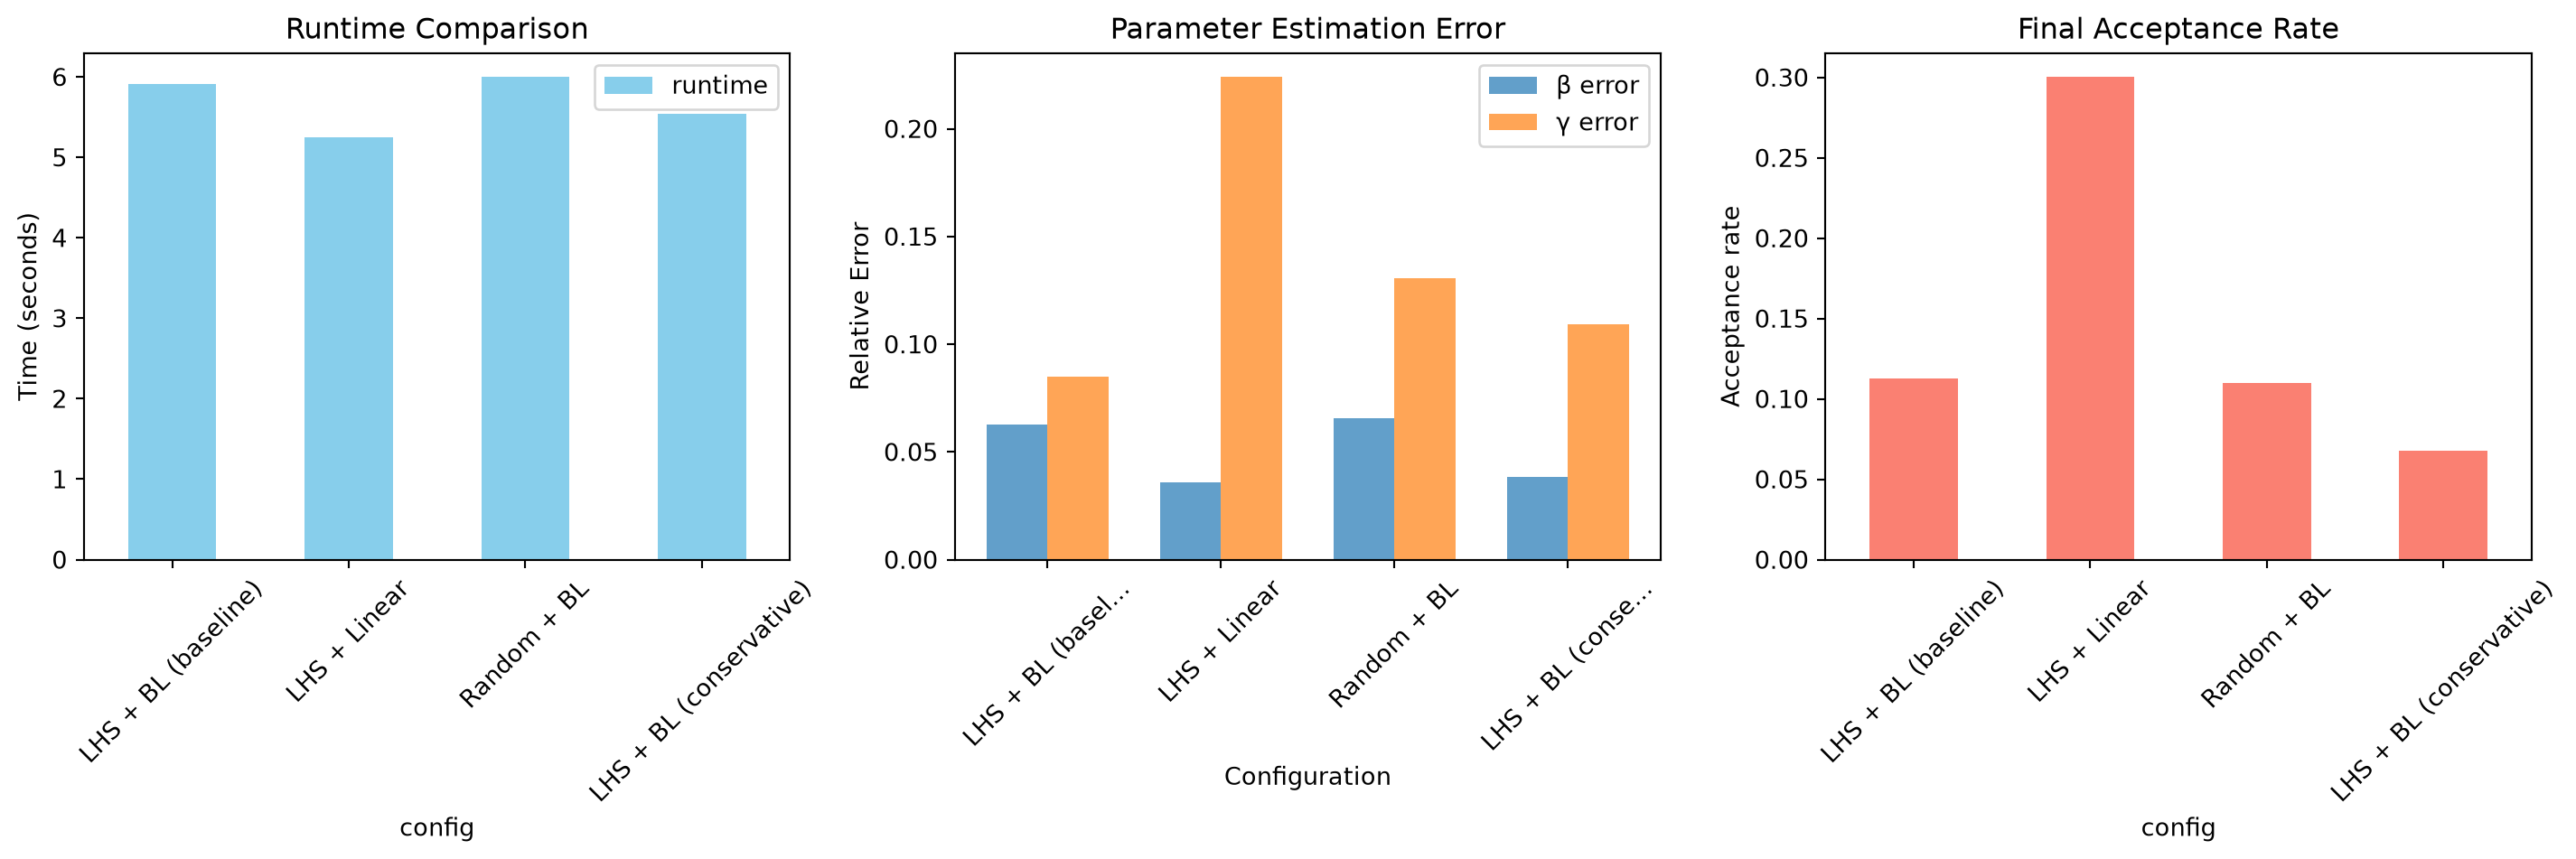
 Configuration Comparison Summary:
================================================================================
Configuration             Runtime(s)   Samples    β Error    γ Error    Acc. Rate 
================================================================================
LHS + BL (baseline)       5.9          200        6.3%       8.5%       0.113     
LHS + Linear              5.2          200        3.6%       22.4%      0.300     
Random + BL               6.0          200        6.6%       13.1%      0.110     
LHS + BL (conservative)   5.5          200        3.8%       10.9%      0.067     

 Best performing configurations:
 Fastest: LHS + Linear
 Most samples: LHS + BL (baseline)
 Lowest β error: LHS + Linear
 Lowest γ error: LHS + BL (baseline)

Checkpoint and Resume Functionality

For long-running workflows, the engine supports saving and loading checkpoints.

# Build a small engine to demonstrate monitoring
simple_obs = {
    'peak_incidence': (incidence_obs.max(), 50),
    'total_cases':    (incidence_obs.sum(), 200),
}

progress_log = []
feature_history = []

def monitor_callback(progress):
    progress_log.append({
        'iteration':   progress.current_iteration,
        'acceptance':  progress.acceptance_rate,
        'total':       progress.samples_generated,
        'accepted':    progress.samples_accepted,
    })

monitor_engine = hm.HistoryMatching(
    bounds={'beta': (0.5, 3.0), 'gamma': (0.1, 1.0)},
    observations=simple_obs,
    function=enhanced_sir_simulation,
    emulator_type='bayes_linear',
    n_samples=300,
    max_iterations=4,
    random_seed=7,
)
monitor_engine.add_progress_callback(monitor_callback)

mon_results = monitor_engine.run()
for r in mon_results:
    feature_history.append(r.emulated_outputs)

print("Iteration | Acceptance | Features selected")
print("-" * 55)
for i, (p, feats) in enumerate(zip(progress_log, feature_history), 1):
    print(f"    {i}     |   {p['acceptance']:.3f}    | {feats}")
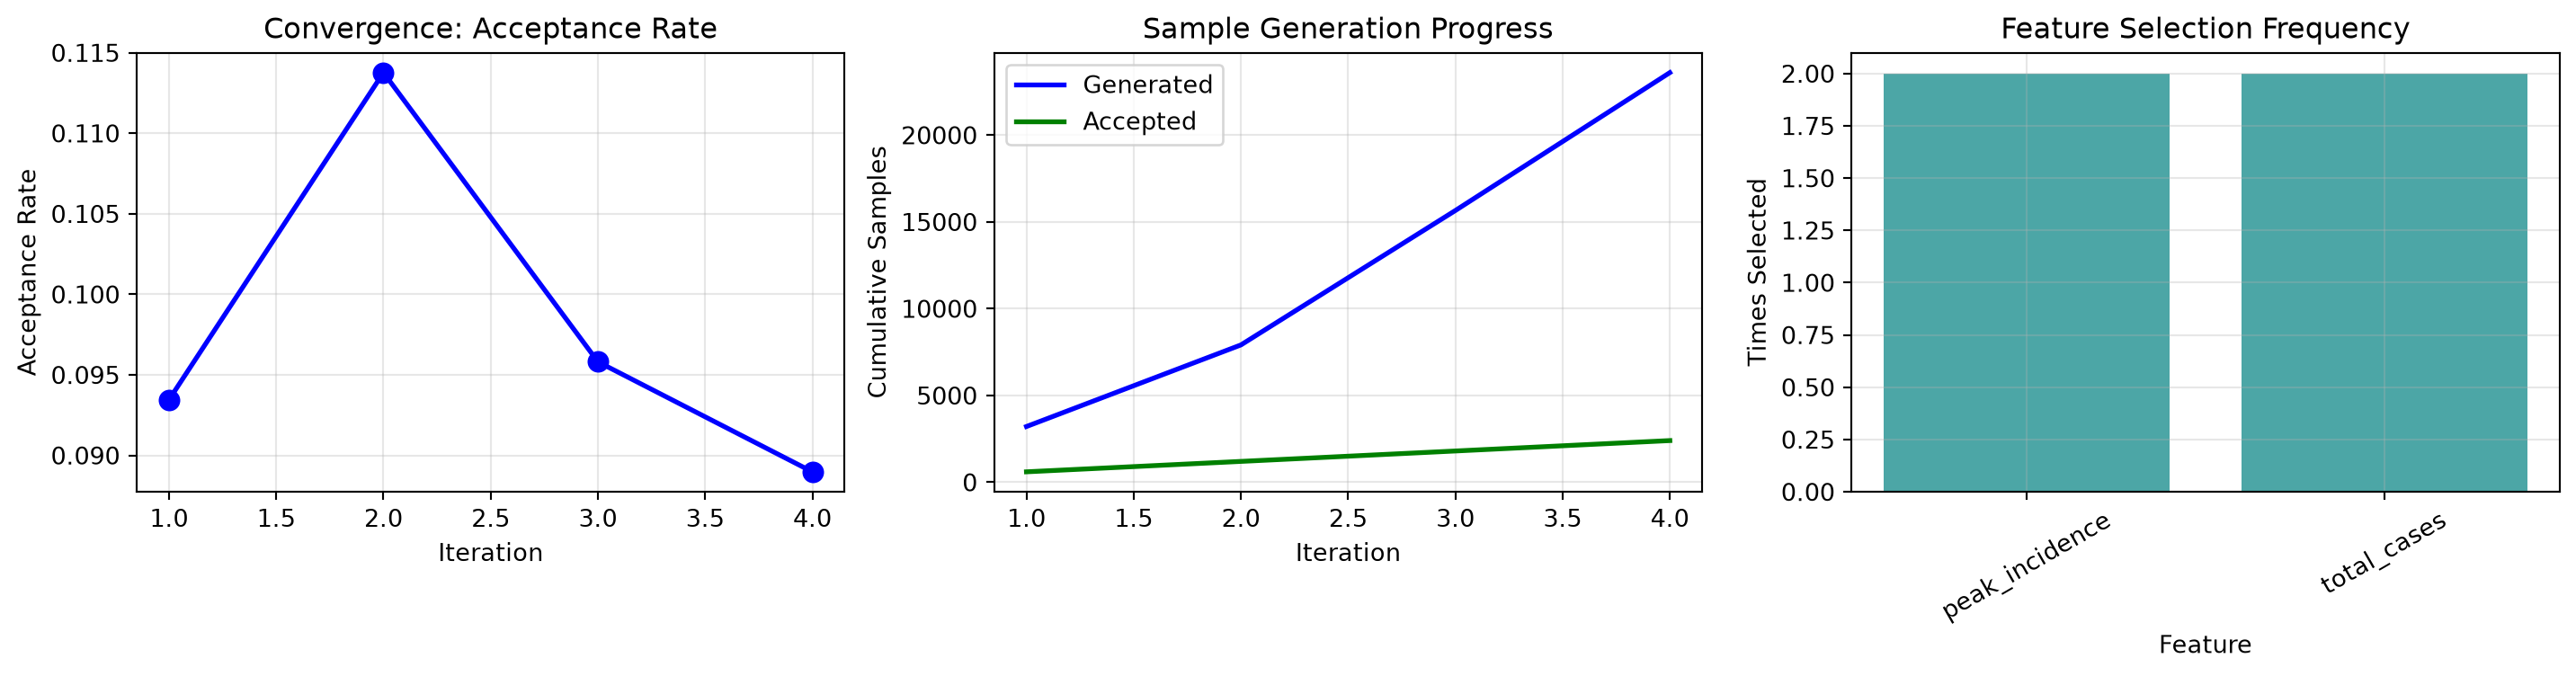
Iteration | Acceptance | Features selected
-------------------------------------------------------
    1     |   0.093    | ['peak_incidence']
    2     |   0.114    | ['total_cases']
    3     |   0.096    | ['peak_incidence']
    4     |   0.089    | ['total_cases']
fig, axes = plt.subplots(1, 3, figsize=(15, 4))

# Acceptance rate over iterations
ax = axes[0]
iters = [p['iteration'] for p in progress_log]
rates = [p['acceptance'] for p in progress_log]
ax.plot(iters, rates, 'bo-', linewidth=2, markersize=8)
ax.set_xlabel("Iteration")
ax.set_ylabel("Acceptance Rate")
ax.set_title("Convergence: Acceptance Rate")
ax.grid(True, alpha=0.3)

# Cumulative samples
ax = axes[1]
ax.plot(iters, [p['total']    for p in progress_log], 'b-', label='Generated', linewidth=2)
ax.plot(iters, [p['accepted'] for p in progress_log], 'g-', label='Accepted',  linewidth=2)
ax.set_xlabel("Iteration")
ax.set_ylabel("Cumulative Samples")
ax.set_title("Sample Generation Progress")
ax.legend()
ax.grid(True, alpha=0.3)

# Feature selection frequency
ax = axes[2]
from collections import Counter
feat_counts = Counter(f for feats in feature_history for f in feats)
ax.bar(feat_counts.keys(), feat_counts.values(), color='teal', alpha=0.7)
ax.set_xlabel("Feature")
ax.set_ylabel("Times Selected")
ax.set_title("Feature Selection Frequency")
ax.tick_params(axis='x', rotation=30)
ax.grid(True, alpha=0.3)

plt.tight_layout()
plt.show()

Monitoring Convergence with Progress Callbacks

Progress callbacks let you track acceptance rate, feature selection, and space reduction across iterations — useful for deciding when the workflow has converged.

# Save current state as checkpoint
checkpoint_path = Path('./advanced_engine_checkpoint.pkl')
advanced_engine.save_checkpoint(checkpoint_path)
print(f"Checkpoint saved to {checkpoint_path}")

# Demonstrate loading from checkpoint
print(f"\nLoading engine from checkpoint...")

# Create new strategies for loading (required parameters)
sampling_strategy = hm.SamplingStrategyFactory.create('lhs')
feature_strategy = hm.AutoFeatureSelection(method='mean_sq_z', max_features=3)
emulator_factory = hm.EmulatorFactory('bayes_linear')

loaded_engine = hm.HistoryMatching.load_checkpoint(
    checkpoint_path,
    sampling_strategy=sampling_strategy,
    feature_selection=feature_strategy, 
    emulator_factory=emulator_factory
)

loaded_engine.function = enhanced_sir_simulation

print(f"Engine loaded successfully!")
print(f"  Current iteration: {loaded_engine.current_iteration}")
print(f"  Total samples accepted: {loaded_engine.samples_accepted}")
print(f"  Emulators trained: {loaded_engine.emulators_trained}")

# Can continue from where we left off
if loaded_engine.current_iteration < loaded_engine.max_iterations:
    print(f"\nContinuing workflow from checkpoint...")
    
    # Run one more iteration to demonstrate
    next_result = loaded_engine.step()
    print(f"  Additional iteration completed: {len(next_result.samples)} samples")
    loaded_engine.commit_step()
    
    print(f"  Updated progress: Iteration {loaded_engine.current_iteration}, "
          f"Rate: {loaded_engine.acceptance_rate:.3f}")

# Clean up checkpoint file
checkpoint_path.unlink()
print(f"\nCheckpoint file cleaned up")
Checkpoint saved to advanced_engine_checkpoint.pkl

Loading engine from checkpoint...
Engine loaded successfully!
  Current iteration: 3
  Total samples accepted: 4000
  Emulators trained: 7

Continuing workflow from checkpoint...
  Additional iteration completed: 800 samples
  Updated progress: Iteration 4, Rate: 0.015

Checkpoint file cleaned up

Summary

This notebook demonstrated advanced features of the history matching library:

Advanced Configuration

  • Single-constructor API: Fine-grained control over all components
  • Custom Strategies: Sampling, feature selection, and emulator configuration
  • DataFrame Inputs: Structured parameter and observation definitions
  • Performance Tuning: Threshold, oversampling, and optimization settings

Interactive Workflow Control

  • Step-by-Step Execution: Manual control over each iteration
  • Strategy Switching: Dynamic reconfiguration during workflow
  • Rollback Capability: Revert unsatisfactory iterations
  • Progress Monitoring: Real-time callbacks and diagnostics

Advanced Analysis

  • Comprehensive Diagnostics: Parameter recovery assessment
  • Performance Comparison: Different configuration strategies
  • Evolution Tracking: Parameter space reduction over iterations
  • Feature Selection Analysis: Understanding which features matter most

Enterprise Features

  • Checkpoint/Resume: Save and restore workflow state
  • Extensible Design: Custom emulators and strategies
  • Scalable Architecture: Handle complex, high-dimensional problems

Key Takeaways

  1. Emulator choice: Bayes linear (the default) achieves nearly the same accuracy as GPR at a fraction of the runtime — see the Emulator showcase for the head-to-head comparison; linear and GLM are faster still, but less flexible for nonlinear responses
  2. Feature Selection Strategy: Automatic selection often finds good features, manual gives control
  3. Sampling Strategy: LHS typically provides better space coverage than random sampling
  4. Threshold Tuning: Conservative thresholds (≤3.0) balance precision and coverage
  5. Interactive Workflow: Powerful for research and model development scenarios

The single-constructor API provides the flexibility needed for advanced applications while maintaining ease of use for standard workflows.